CAPABILITY 01
纯强化学习逻辑自省推理
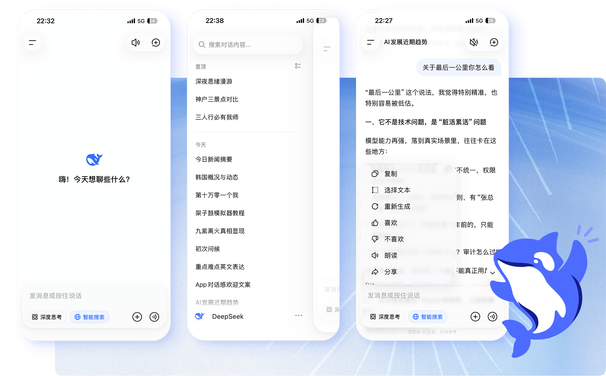
摆脱对人类监督微调(SFT)数据的依赖,DeepSeek-R1 依靠大规模纯强化学习自发涌现反思纠错、多路径假设与深层逻辑推演机制。
面向通用人工智能目标,DeepSeek 坚持第一性原理探索。依托自研 MLA 多头潜在注意力与纯强化学习 R1 模型体系,在数学推理、代码编写与长文本逻辑推演中突破传统开销约束,为全球科研与工程开发者呈现高鲁棒、低延迟的智能底座。
从算子底层重构到纯强化学习逻辑自省,DeepSeek 持续以技术创新突破大模型工程上限。
摆脱对人类监督微调(SFT)数据的依赖,DeepSeek-R1 依靠大规模纯强化学习自发涌现反思纠错、多路径假设与深层逻辑推演机制。
Multi-head Latent Attention 原创架构将推理 KV Cache 显存消耗压缩为传统 MHA 的五分之一,实现数百倍并发吞吐与超低首字延迟。
原生支持 128,000 Tokens 长文本无损检索,单次会话可通读数十万字工程项目源码、整卷法典或全套跨期财务审计底稿。
坚守开源普惠承诺,模型权重对全社会完全开放,API 缓存命中单价低至 0.14元/百万tokens,推动工业界低门槛普及大模型。
DeepSeek 广泛应用于高难度科学推演、复杂软件工程治理与企业私有化知识库重构。
在数论、组合概率与微积分等学术前沿领域提供严格符号推导与定理验证,辅助科研团队快速攻坚复杂数理命题。
跨多个模块定位深层并发竞争 Bug,自动生成高覆盖率单元测试用例,提供安全高效的企业级技术债务优化方案。
自动解析数百页招股书、研报与多期财务报表,比对勾稽关系与潜在财务异常,提炼结构化投资决策指标。
结合向量数据库与重排机制,快速打通企业内部 Wiki、ERP 与合同文档,构建高精准度的端到端业务咨询中枢。
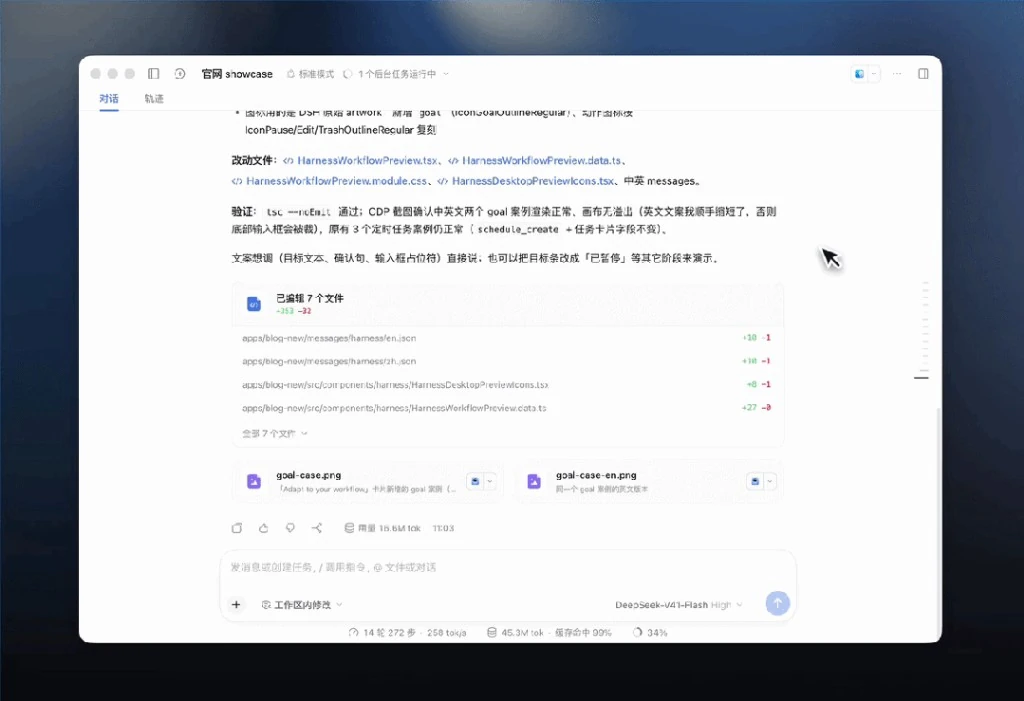
在持续集成 CI/CD 流程中引入 Harness 基准评测套件,自动化回归大模型在数学、代码与合规性层面的综合得分。
支持在本地数据中心使用 vLLM、SGLang 或 Ollama 离线加载模型权重,彻底杜绝核心企业机密外泄风险。
无论您需要零配置的即开对话、企业级云端 API 还是内网完全离线部署,DeepSeek 均能提供精准匹配。
无需重构业务核心代码,基于标准接口协议,5 分钟内完成生产级大模型推演集成。
登录 DeepSeek 开发者控制台,在安全凭证中心一键生成长效或临时 API Key。
将客户端或第三方工具的调用地址重定向至 https://api.deepseek.com 服务节点。
在请求参数中直接指定 deepseek-chat 或强化学习模型 deepseek-reasoner。
服务端自动对重复上下文触发缓存机制,命中费率立降至 0.14元/百万tokens。
打通浏览器、命令行、企业微服务与本地物理算力,让顶尖通用智能触手可及。
不堆砌虚幻口号,以第一性原理指标呈现 DeepSeek 在算力利用率与成本边界上的实质飞跃。
针对开发者与企业用户关心的核心疑问,提供透明、客观、权威的技术解答。
DeepSeek 网页版对所有个人研究人员与公众免费开放,涵盖完整的 DeepSeek-V3 与 DeepSeek-R1 推理能力,无需繁杂配置即可体验完整的自省思维链;而 API 开放平台专为开发者和系统集成设计,提供毫秒级高并发接口、自定义温度参数、流式推送与 SLA 可靠性承诺,采用透明计费模式。
DeepSeek-R1 采用了纯强化学习逻辑自省训练框架。在输出最终答案前,模型会自发调用内部思维空间(Chain of Thought),对潜在解法进行枚举、质疑、回溯与边界修正。显式输出思维链不仅极大增强了数理与代码推导的准确性,也为用户提供了可追溯、可审计的白盒思考逻辑。
DeepSeek API 严格遵循 OpenAI 工业级 RESTful 与 Chat Completions 数据接口标准。您仅需将客户端 SDK 中的 base_url 配置为 https://api.deepseek.com,并将模型名指定为 deepseek-chat 或 deepseek-reasoner,无需更改任何业务代码即可完成迁移。
DeepSeek Harness 是我们面向工业界开源的一站式模型能力评测框架。它集成了数学基准(AIME/MATH)、代码编写(HumanEval/MBPP)、指令遵循与安全红蓝对抗测试集,能够自动化生成标准评测雷达图,帮助企业科学验证微调或量化后的模型质量。
对于 1.5B ~ 14B 等蒸馏模型,单张主流消费级显卡(如 RTX 4090)即可流畅运行;对于 32B ~ 70B 模型,建议配置 2~4 张工业级算力卡;而对于 671B 满血版 MoE 模型,推荐基于 8 卡 H800/A800 集群采用 vLLM 或 SGLang 框架进行 FP8 量化部署。
实时跟踪 DeepSeek 架构演进、版本更新与开源技术社区最新动态。
彻底突破人类微调语料依赖,在复杂数理与多步代码演进中展现出惊人的自省反思与自我纠错能力。
得益于 MLA 架构在服务端 KV Cache 的压缩突破,API 开放平台再次下调 Token 价格,助力行业规模化降本。
面向企业级大模型落地测试的端到端自动化评估工具包,涵盖数理基准、代码生成与多维度鲁棒性验证。
深入阐释多头潜在注意力如何在保证语义表达容量的前提下,将 Key-Value 缓存压缩至传统模式的 20%。
包含 1.5B、7B、8B、14B、32B 等多尺寸权重,完全保留 R1 推理思维链特征,支持在轻量边缘设备离线部署。
面向高校科研团队、开源项目与初创开发者推出算力扶持通道,提交项目申请即可申领高额 API 抵扣额度。