1. 快速接入指南 · 兼容 OpenAI 协议
DeepSeek API 开放平台完全遵循 OpenAI RESTful 接口规范。开发者无需替换现有客户端 SDK 架构,仅需在代码中调整服务根路径 base_url 与 API Key 即可无缝切换。
| 配置项 | 标准值 | 说明 |
|---|---|---|
| Base URL | https://api.deepseek.com |
主服务生产节点(全球高并发 Anycast 加速) |
| API Key 获取 | 控制台安全中心创建 | Bearer Token 鉴权,支持细粒度权限控制 |
| 兼容 SDK | openai Python / Node.js SDK |
直接传入 custom base_url 即可 |
from openai import OpenAI

# 仅需调整 base_url 与 api_key
client = OpenAI(
    api_key="your_deepseek_api_key_here",
    base_url="https://api.deepseek.com"
)

response = client.chat.completions.create(
    model="deepseek-reasoner",  # 强化学习满血推理模型
    messages=[
        {"role": "system", "content": "你是一位精通分布式系统与数理建模的资深首席架构师。"},
        {"role": "user", "content": "请推演多节点 Paxos 共识算法在分区网络下的活性与安全性边界。"}
    ],
    stream=True
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
2. 模型清单与调用参数规范
DeepSeek 开放平台主要提供两大旗舰模型端点:专注于通用复杂任务超高吞吐的 deepseek-chat,以及面向深度数理推演与算法自省的 deepseek-reasoner。
| 模型名称 | 底层架构 | 上下文长度 | 核心适用场景 |
|---|---|---|---|
| deepseek-chat | DeepSeek-V3 (671B MoE) | 128,000 Tokens | 高并发日常会话、中英翻译、通用编程、企业知识库检索 |
| deepseek-reasoner | DeepSeek-R1 (纯强化学习) | 128,000 Tokens | AIME 级数理难题推导、多步逻辑反思、复杂并发算法设计 |
3. 计费体系与上下文缓存(Context Caching)
得益于自主研发的 MLA 多头潜在注意力机制,DeepSeek 服务端能够以极其紧凑的显存保存 Key-Value 缓存。当系统识别到相同前缀的上下文(如系统提示词、长代码工程或历史多轮会话)时,将自动激活极速缓存命中。
| 模型端点 | 输入 Token(缓存命中) | 输入 Token(缓存未命中) | 输出 Token 单价 |
|---|---|---|---|
| deepseek-chat | ¥0.14 / 1M tokens | ¥1.00 / 1M tokens | ¥2.00 / 1M tokens |
| deepseek-reasoner | ¥0.55 / 1M tokens | ¥4.00 / 1M tokens | ¥16.00 / 1M tokens |
* 计费以服务端精准统计为准,以 64 tokens 为缓存分块粒度。未命中部分按实际消耗计收,账单按秒级实时更新。
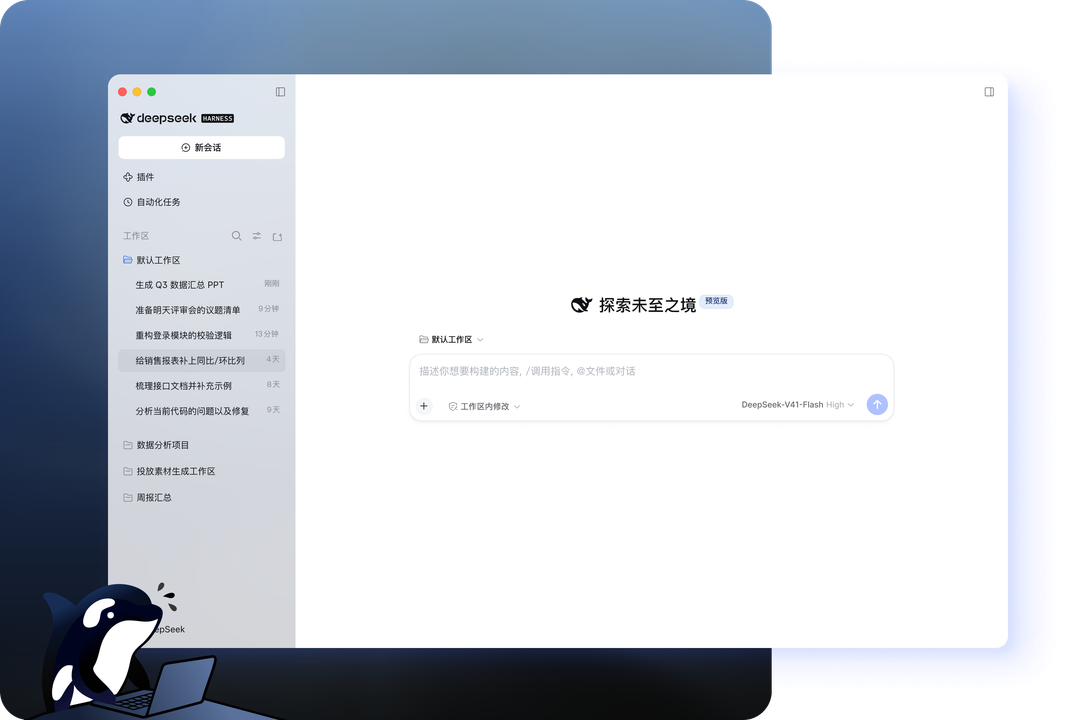
4. DeepSeek Harness 自动化模型评测套件
DeepSeek Harness 是面向企业级工业大模型生命周期的标准化评测与自动化回归流水线。支持自动化装载对抗用例集、AIME 2024、MATH-500、HumanEval 与 LiveCodeBench,帮助工程团队在模型迭代、量化或微调前后进行严谨量化。
# 安装 DeepSeek Harness 评测套件
git clone deepseek-harness && cd deepseek-harness
pip install -r requirements.txt

# 运行数学逻辑与代码自动化测试基准
python evaluate.py \
  --model_path "https://api.deepseek.com" \
  --model_name "deepseek-reasoner" \
  --tasks "aime2024,math500,humaneval" \
  --batch_size 16 \
  --output_dir "./eval_reports"
5. 本地私有化离线部署指南
对于国防、金融与核心政企内网环境,DeepSeek 坚持全尺寸开源生态。您可以借助 Ollama、vLLM 或 SGLang 框架在内网完全物理隔离集群中一键加载模型权重。
| 模型规格 | 推荐推理框架 | 最低硬件配置 | 显存需求 |
|---|---|---|---|
| DeepSeek-R1-Distill-1.5B ~ 8B | Ollama / llama.cpp | 单卡 RTX 3060 / 4060 | 8GB ~ 16GB |
| DeepSeek-R1-Distill-14B ~ 32B | vLLM / SGLang | 单卡 RTX 4090 或 A100 (40G) | 24GB ~ 40GB |
| DeepSeek-R1-671B (FP8 MoE) | vLLM 官方集群镜像 | 8卡 H800 / A800 集群 | 8 × 80GB 显存 |
6. 开发者常见 FAQ 与排错指南
A: 429 通常代表当前并发请求数超出了分配等级。建议在客户端集成 Exponential Backoff(指数退避)重试逻辑,或在控制台工单申请提升 QPS 配额。
A: 在流式(stream=True)调用响应的 Delta 结构体中,思维链内容存放在 reasoning_content 字段中,最终答案存放在标准的 content 字段中。